首页 > 组学服务
宏基因组测序是不依赖培养,直接从环境样品(如土壤、水体、肠道、皮肤等)中提取全部微生物的 DNA,进行高通量测序,以分析微生物群落的物种组成、基因功能及相互关系的技术。
产品热点:
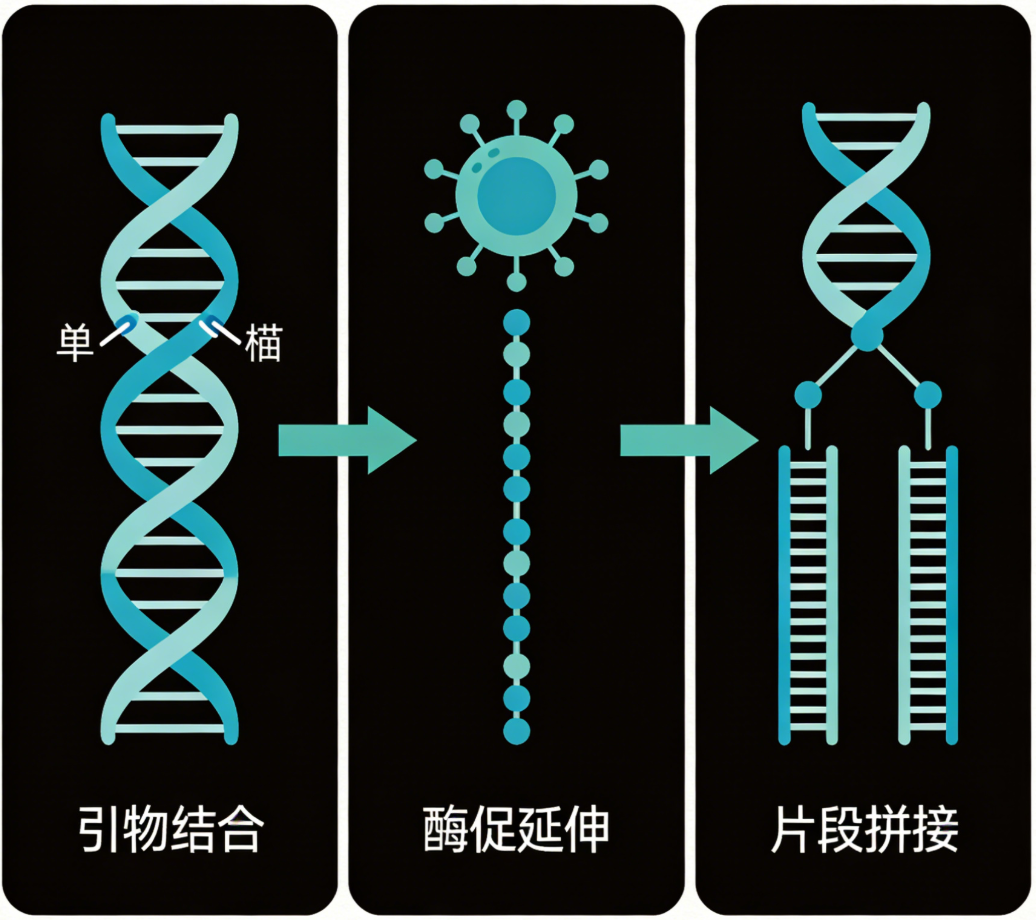
宏基因组测序技术突破传统分离培养局限,在无目标菌预设前提下,对样本微生物总基因组进行高通量测定与深度分析,能够全面表征群落组成、基因功能、代谢通路、耐药基因与毒力基因谱,物种注释精度可达种乃至菌株层级;该技术可同步产出物种分类、功能注释与通路富集结果,适用于疾病关联微生物标志物筛选、微生态调控机制解析及干预疗效的客观评价,是微生物组研究的核心技术手段。 ── [ 收样测序 ]
 ── [ 生信分析与深度挖掘 ]
 ── [ 结果交付与售后 ]
|
服务 |
描述 |
|
|
de novo 组装 |
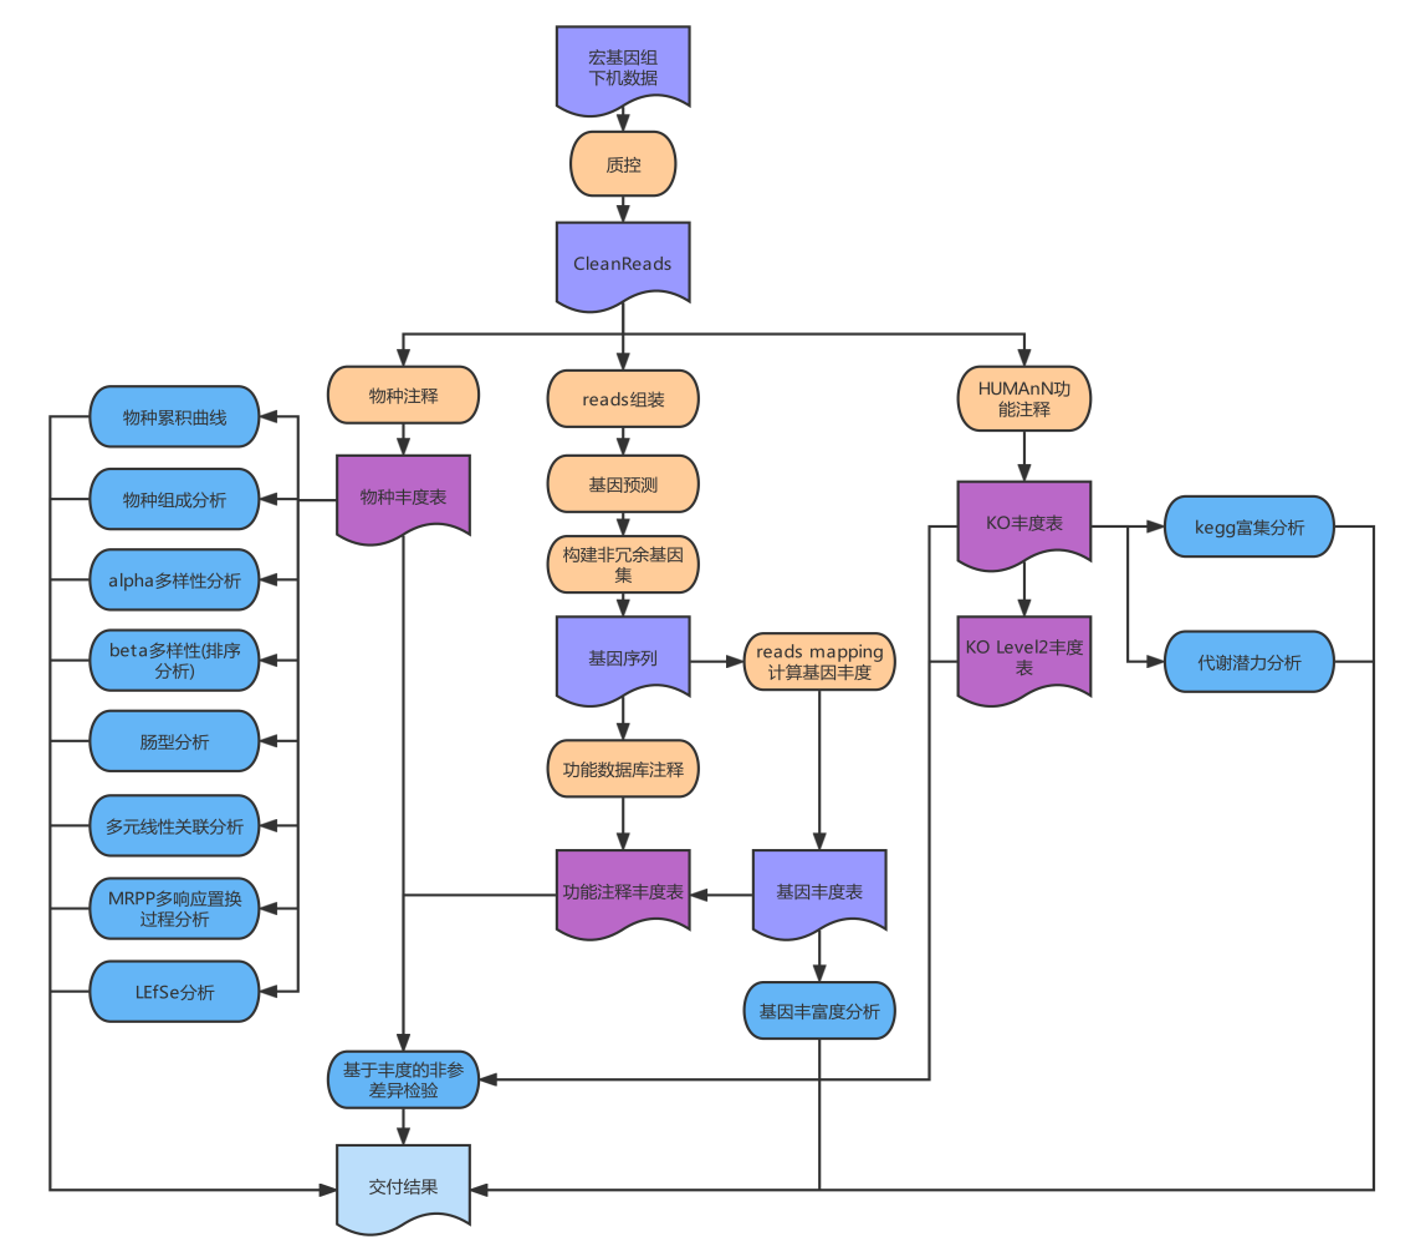
将质控后的高质量测序数据从头组装成 contigs,进一步获得 scaffolds 和 scaftigs |
|
|
基因预测 |
对组装后的 scaftigs 预测开放可读框(ORFs) ,并去冗余得到非冗余 基因集 |
|
|
基因丰度 |
将高质量测序数据 mapping 到非冗余基因集中得到基因的丰度数据 |
|
|
基因功能注释 |
CARD |
基于 CARD 数据库对非冗余基因集做抗生素耐药性的功能注释 |
|
VFDB |
基于 VFDB 数据库对非冗余基因集做致病毒力因子的功能注释 |
|
|
KEGG |
非冗余基因集的 KEGG Orthology 功能注释 |
|
|
CAZy |
基于 CAZy数据库对非冗余基因集做碳水化合物水解酶的功能注释 |
|
|
PHI |
基于 Pathogen Host Interaction Database 对非冗余基因集做功能注 释 |
|
|
TCDB |
基于 TCDB 数据库对非冗余基因集做转运蛋白的功能注释 |
|
|
QS |
非冗余基因集的 Quorum Sensing 注释 |
|
|
MvirDB |
非冗余基因集的生物防御相关基因注释 |
|
|
菌群组成分析 |
分析不同组之间在各分类层级的组成 |
|
|
多样性分析 |
物种累积曲线 |
描述随着抽样量增加物种数增加的状况,判断抽样是否 充分及比较不同组之间的物种丰富度 |
|
Alpha 多样性 |
比较不同组之间的 alpha 多样性差异,包括香农指数, 丰富度,均匀度等 |
|
|
基因丰富度 |
比较不同组之间的基因多样性 |
|
|
降维聚类分析 |
PCA 主成分分析 |
将高维数据,如物种丰度降维后在二维/ 三维上展示 |
|
PCoA 主坐标分析 |
常用于分析样本之间的相似性,基于样本之间的距离将 高维数据投影到低维空间展示 |
|
|
NMDS 非度量多维尺度分析 |
将高维样本在低维空间进行定位,分析和归类,同时又 保留样本原始关系的方法 |
|
|
Enterotype 肠型分析 |
根据菌群组成的差异将样本划分成不同的集群或组 |
|
|
组间差异分析 |
PERMANOVA 多因素方差分析 |
基于样本之间的距离分析不同表型变量(如分组,年龄 等)对样本差异的解释度,并用置换检验进行显著性分 析 |
|
MRPP多响应置换过程分析 |
类似 permanova,基于样本之间的距离检验两组或多组 之间的差异是否显著 |
|
|
组间 wilcox 检验差异分 析 |
非参检验分析两组之间基因、功能和菌群之间的差异 |
|
|
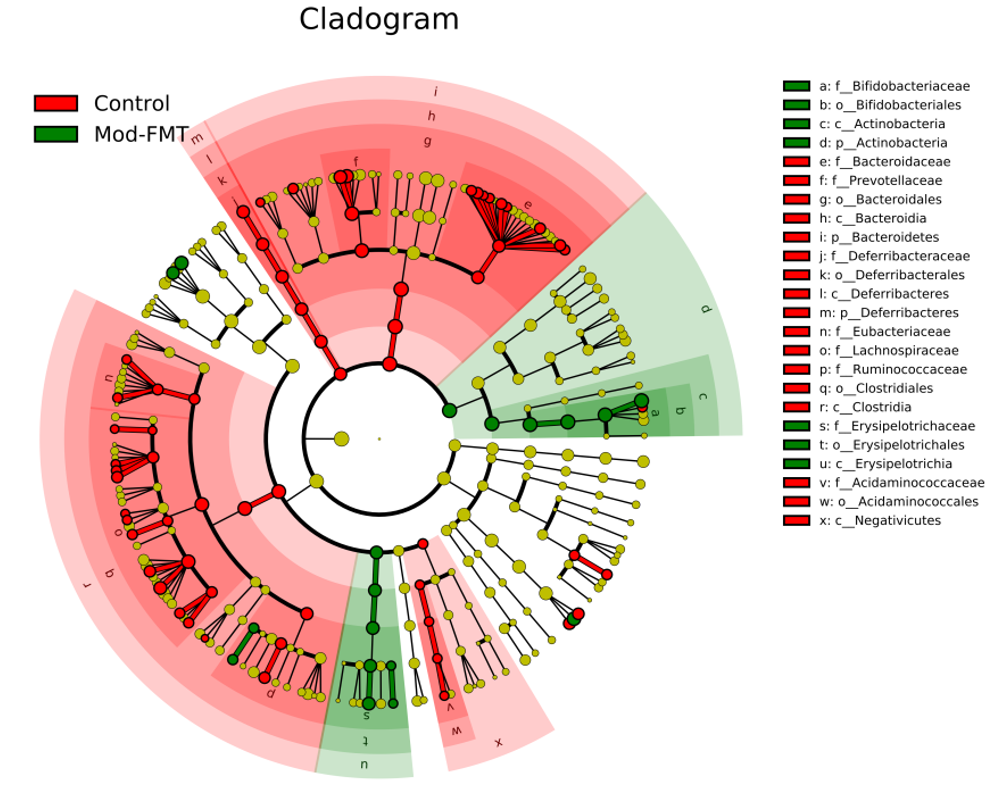
LefSe 差异分析 |
比较两组或多组之间的差异,获得组间丰度差异显著的 biomarker |
|
|
其他分析 |
多元线性关联分析 |
用多元线性关联模型分析多种表型因子与菌群的关系或者多组间的kruskal |
|
通路富集分析 |
两组间差异显著的基因是否显著富集在某些通路上 |
|
|
代谢物潜力分析 |
基于物种的丰度及物种与代谢物之间的关系计算代谢 物丰度,比较两组之间的差异 |
|
②高级分析:
|
服务 |
描述 |
|
|
次级代谢产物分析 |
基于组装的结果预测次级代谢产物 |
|
|
基因物种注释 |
对非冗余基因集通过比对 NR 数据库做物种注释 |
|
|
Metagenomics- Assembled Genomes (MAGs) |
Binning(分箱) |
对 de novo 组装获得的 contigs 进行 binning 分析, 获得 MAGs |
|
丰度定量 |
将测序数据 mapping 到 MAGs序列上获得其丰度信息 |
|
|
物种注释 |
根据ANI对 MAGs 做物种注释 |
|
|
网络分析 |
根据物种丰度在样本中的相关性,构建物种之间的网络 |
|
③统计建模(AI建模范畴):
|
服务 |
描述 |
|
机器学习 |
包括随机森林、支持向量机及多层神经网络,构建基于宏基因组的疾病预测模型等等。 |
④个性化分析
提供生物信息个性化分析咨询和服务,具体流程如下: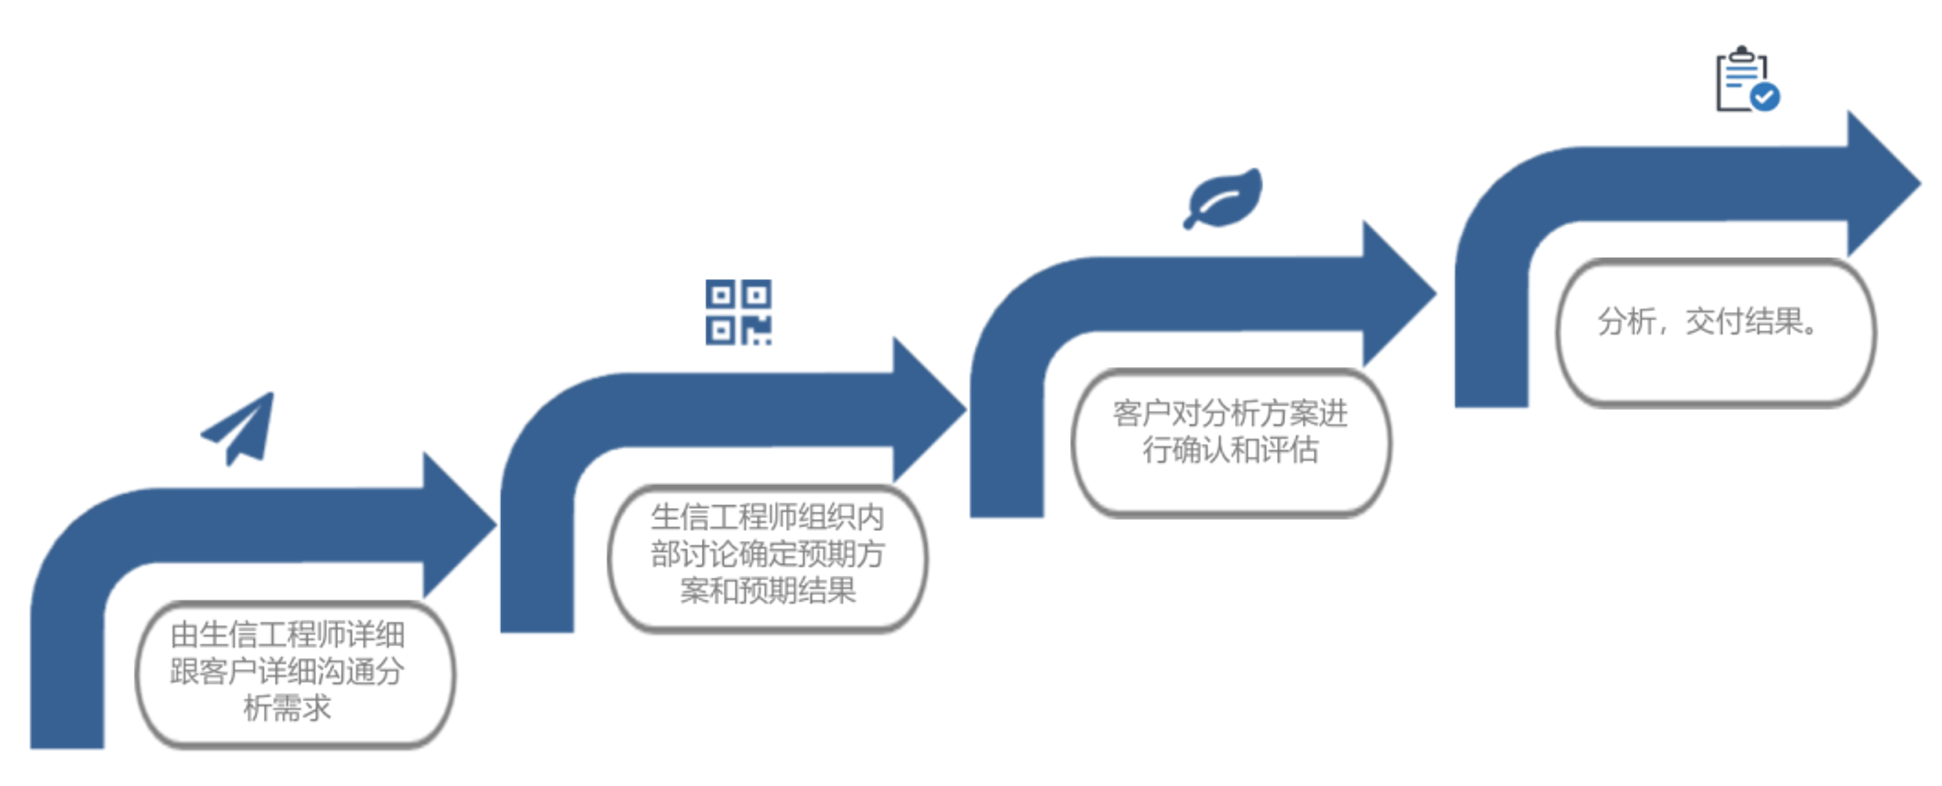
电话:15010946773
邮箱:sotk2025@126.com