首页 > 组学服务
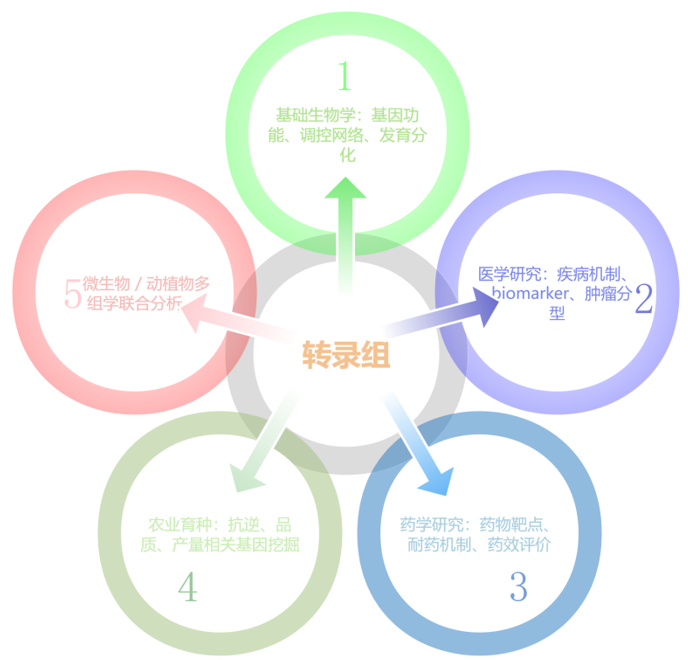
转录组测序是对特定组织 / 细胞在某一状态下的全部转录产物(mRNA 与非编码 RNA)进行高通量测序,全面获取基因表达、可变剪接、新转录本等信息,用于解析基因功能、调控网络、疾病机制与分子标志物的核心技术。
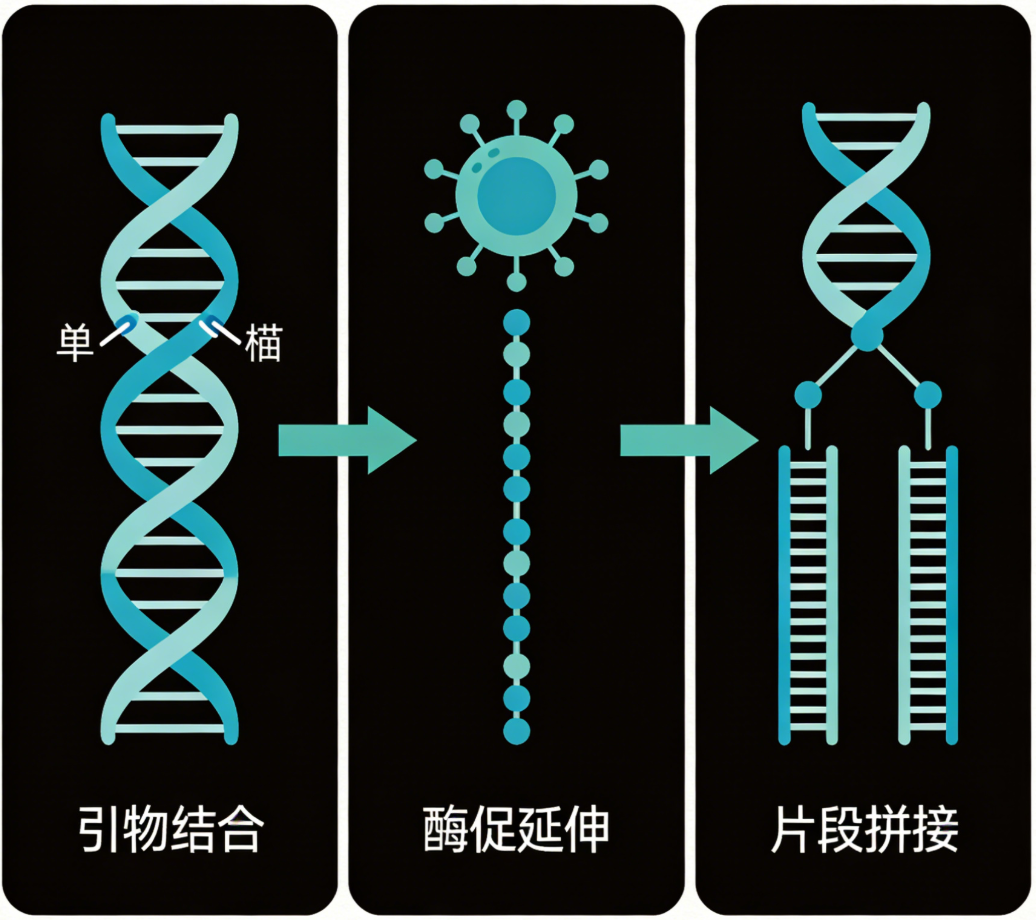
真核有参转录组测序依托Illumina 高通量测序平台,将测序数据与参考基因组比对,完成表达定量、差异分析、功能注释与机制挖掘,是基础研究、临床诊断、新药研发与分子育种的主流技术。
1、数据全面精准:一次性获取样本全部转录本信息,覆盖编码与非编码 RNA,检测灵敏度高、数据量大。
2、分析深度完整:从数据质控、基因组比对、基因定量到差异分析、功能富集、网络分析一站式完成。
3、应用场景广泛:适用于发育机制、疾病致病机理、药物响应、分子标记筛选、调控网络解析。
4、结果标准化:提供用于论文发表的图表(可个性化定制)、表格与结题报告,降低科研落地成本。
5、技术成熟稳定:流程标准化、重复性好,支持多样本、多时间点实验设计。
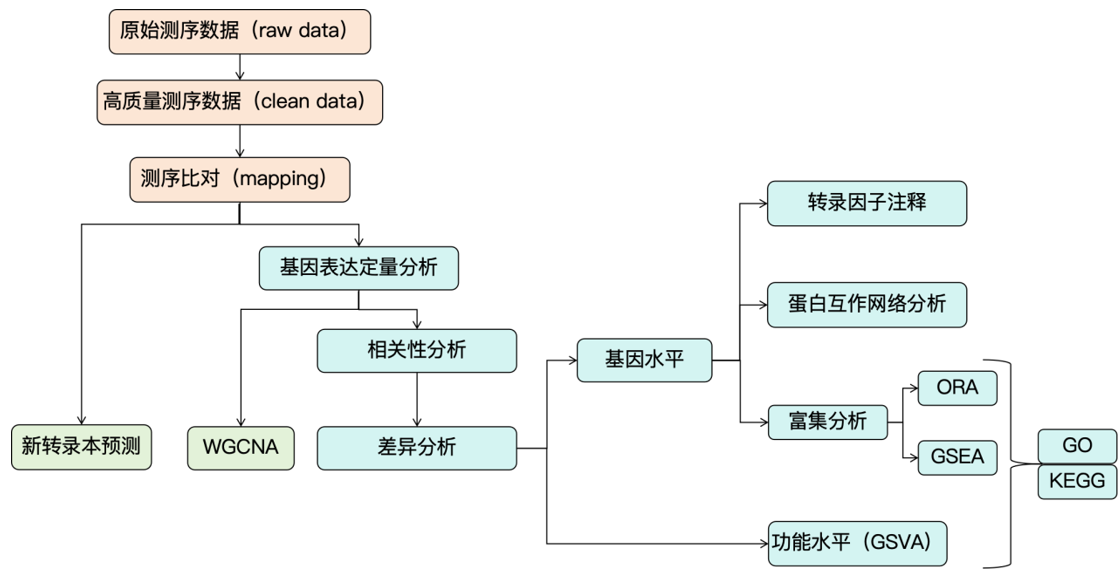
3.1 StringTie软件组装转录本(注,优势:Ⅰ、能够重构出完整性更高的转录本;Ⅱ、所获得的转录本具有更高的精确度;Ⅲ、组装速度更快。);
3.2 GffCompare软件鉴定新转录本。
4.1 测序reads饱和度分析:附上全部样本的测序 Reads 饱和度分析曲线;
4.2 基因表达分布:为了直观展示各样本中基因表达量的整体分布情况,我们基于所有样本全部基因的TPM值,使用R语言绘制了“小提琴图”和“箱线图”;
4.3 样本间相关性:利用各样本的TPM或FPKM表达量矩阵,计算两两样本之间的相关系数,通过⽐较这些系数的⼤⼩,可以初步判断同一实验分组内生物学重复的稳定性;
4.4 样本降维分析:主成分分析(PCA)、UMAP降维分析、多维尺度分析(MDS);
5.1 基因水平:需通过统计学方法筛选出在不同实验条件下呈现显著差异的基因,该过程通常包含四个主要环节:基因过滤、数据标准化、假设检验、多重检验校正;
5.2 功能水平(GSVA):GO基因集,KEGG基因集;
电话:15010946773
邮箱:sotk2025@126.com